30 мин чтенияMarkdown
P-Video: полное руководство по четырём моделям Pruna
Четыре модели, одно семейство: дешёвый генератор и три модели для исполнения. Что принимает каждая, сколько стоит дубль и каких сбоев ждать.
Pruna делает четыре видеомодели, и они друг с другом не конкурируют. Одна делает клип из промпта. Три другие оживляют то, что у вас уже есть: портрет и голос, кадр и исполнение, план и новое лицо в нём.
Они стали моделями, к которым мы тянемся в первую очередь, и причина — арифметика. Двадцать секунд человека, говорящего в камеру, стоят здесь 31,5, а у модели классом выше — 200. Пять секунд в 720p стоят 8,5 против 37,5 у следующей по дешевизне модели, способной отрендерить тот же план. Результат достаточно хорош, чтобы экономия перестала быть компромиссом и стала выбором по умолчанию.
Четыре модели — это не четыре вещи, которые нужно изучить. Это один вопрос — что уже у вас в руках? — заданный четырьмя способами.
ПРИМЕЧАНИЕ: всё сказанное здесь верно для всех четырёх, если не названа конкретная модель.
Цена, входные данные и ограничения каждой — на её странице модели: P-Video, P-Video Avatar, P-Video Animate и P-Video Replace.
Обзор
Коротко
Четыре решения делают большую часть работы. Если больше ничего не прочитаете, прочитайте их. Каждое подробно разобрано ниже.
-
Выбирайте модель по тому, что у вас уже есть, а не по тому, чего хотите
Четыре модели чётко делятся по входам, и пересечений между ними нет. Три из них отказываются запускаться без загруженных вами медиа, так что модель выбирается за вас в тот момент, когда вы понимаете, что у вас в руках — голос, видео или ничего.
Только слова → P-Video. Портрет и голос → Avatar. Кадр и исполнение, которое нужно повторить → Animate. План, в котором человек должен стать кем-то другим → Replace.
-
Дубль с исполнением стоит фиксированную цену, что бы ни вышло
Avatar, Animate и Replace берут длину из прикреплённых медиа, поэтому дубль оценивается по потолку в пятнадцать секунд и никогда не дороже. Клип на 4,5 секунды и клип на 17,9 секунды обошлись в одну и ту же сумму — так что короткая реплика тратит впустую бюджет, который длинная использовала бы бесплатно.
Пишите до потолка. Два предложения и шесть предложений стоят одинаково, поэтому вкладывайте мысль целиком в один дубль, а не делите её на два.
-
То, что вы прикрепляете, важнее того, что вы пишете
У трёх моделей исполнения тайминг, движение и игру несёт ведущий вход, а промпт лишь украшает то, что осталось. Свойство, которое задают медиа, не переспорить прозой — на просьбу «curious, then a chuckle, then a complicated smile» модель вернула одну сплошную приятную улыбку, потому что управляет ртом по звуковой волне.
Вместо того чтобы
Писать нужное выражение лица в промпт
Сделайте
Заложите его в исходный кадр или в дубль, который ведёт модель
-
У P-Video нет слота для референса — у неё есть кадры
Ей нельзя передать персонажа и попросить именно его. Можно передать точную картинку, с которой клип начинается, точную картинку, к которой он приходит, или обе. Загруженный кадр к тому же отменяет вашу настройку Форма кадра: его ширина относительно высоты. 16:9 — широкий формат телевизора, 9:16 — телефон, который держат вертикально., потому что соотношение берётся из изображения.
Сначала зафиксируйте объект в одном изображении, затем передайте это изображение как начальный кадр. Постоянство здесь даёт картинка, а не промпт.
Всё семейство в одной таблице
| Модель | Нужно | Также принимает | Длина | Форма кадра | Звук |
|---|---|---|---|---|---|
| P-Video | промпт | начальный кадр, конечный кадр, одна аудиодорожка | 1–10 с или по длине аудио | семь вариантов, если кадр не задаёт свой | генерируется, отключаемый |
| P-Video Avatar | портрет и голосовая дорожка | необязательный промпт | ровно по голосу | как у портрета | ваш голос |
| P-Video Animate | изображение и исходное видео | необязательный промпт | по исходнику | как у исходника | из исходника, всегда включён |
| P-Video Replace | исходное видео и 1–3 образа | необязательный промпт | по исходнику | как у исходника | из исходника, отключаемый |
Все четыре рендерят в 720p или 1080p, и все четыре принимают промпт длиной до 4000 символов — вдвое больше, чем у модели изображений, и больше, чем нужно любой из них. У трёх из четырёх промпт необязателен, и один из разобранных ниже примеров был запущен с пустым промптом.
Сколько это стоит
P-Video оплачивается посекундно, и это самый дешёвый способ в каталоге превратить промпт в движущуюся картинку — $0,02 за секунду в 720p, меньше половины ставки любой другой модели, которая рендерит в таком размере.
| Длина | 720p | 1080p | Для чего |
|---|---|---|---|
| 1 с | 2 | 3,5 | Акцентная склейка. Одна секунда здесь — реальный вариант |
| 3 с | 5 | 10 | Реакция, бит, план, в котором происходит одно событие |
| 5 с | 8,5 | 17 | По умолчанию. Законченная мысль |
| 10 с | 17 | 33,5 | Потолок, и достаточно, чтобы уместить два бита |
Остальные три стоят фиксированную цену. Длина принадлежит прикреплённым медиа, поэтому длительность никогда не отправляется, а дубль оценивается по потолку — на пятнадцать секунд, — и итоговое списание никогда его не превышает. Каждый запущенный нами дубль обошёлся ровно в эту сумму, был ли клип длиной четыре секунды или двадцать:
| Модель | 720p | 1080p |
|---|---|---|
| P-Video Avatar | 31,5 | 56,5 |
| P-Video Animate | 37,5 | 75 |
| P-Video Replace | 37,5 | 75 |
На пятнадцати секундах останавливается цена, а не клип. Композер показывает потолок, потому что именно столько резервируется, а модель вообще не получает длительность — реплика на 17,9 секунды и реплика на 20,16 секунды вернулись целиком и обе стоили 31,5.
Так что не режьте фрагмент, чтобы уложиться в число, которое не является лимитом. Режьте по настоящему шву или не режьте вовсе.
Почему они стали выбором по умолчанию
Те же три задачи и цены на то, чем ещё в каталоге их можно сделать:
| Задача | Pruna | Что ещё это умеет |
|---|---|---|
| Пять секунд клипа в 720p | P-Video 8,5 | Seedance 2.0 Mini 37,5 · Seedance 2.5 в 480p 43 · Runway Gen-4.5 50 |
| Двадцать секунд говорящего человека | P-Video Avatar 31,5 | OmniHuman 1.5 200 · три склеенных дубля Veo 3.1 Fast по 8 с 300 · Seedance 2.5 в 720p 385,5 |
| Перенос исполнения на персонажа | P-Video Animate 37,5 | Kling Motion Control 87,5 |
Это не лучшие модели в каталоге, и руководство этого не утверждает. Это модели, на которых дополнительные траты перестают покупать то, что заметит зритель, — а это другое и куда более полезное свойство.
Берите что-то помощнее, когда лицо — это само исполнение, а не просто то, откуда исходят слова, когда камера должна сделать что-то кинематографичное или когда сгенерированный план должен идти дольше десяти секунд одним куском.
Правила
Семь вещей, которые верны, что бы вы ни делали. Каждая обошлась нам в деньги, и они упорядочены по тому, сколько сэкономят вам.
Выбирайте по своим входам, а не по своим амбициям
Три из четырёх отказываются запускаться. То, из-за чего они отказываются, и есть выбор модели, сделанный за вас.
Генерация здесь заблокирована, пока не заполнены обязательные слоты, и в этом вся классификация:
- Avatar нужны изображение и аудиодорожка.
- Animate нужны изображение и видео.
- Replace нужны видео и от одного до трёх образов.
- P-Video не нужно ничего.
Мы столкнулись с этим на плане-реакции: три секунды женщина что-то смотрит и молчит. Нет реплики — значит, нет аудио, а значит, нет ни длины, ни исполнения, из которых модель липсинка могла бы что-то построить; не было и видео, которое можно было бы переиграть другим персонажем. P-Video оказалась единственной из четырёх, кто мог снять этот план, и сняла его за 13,5 в 1080p.
Прочитать требование задом наперёд — быстрый путь к нужной модели. Если вы тянетесь к Avatar, а голосового дубля ещё нет, задача не «сгенерировать клип», а «сначала записать голос».
Дубль с исполнением стоит фиксированную цену, поэтому пишите до потолка
Клип длится столько же, сколько то, что им управляет, а счёт в любом случае — за пятнадцать секунд.
Ни одна из трёх моделей исполнения не принимает длину. Каждый запрос идёт с меткой «авто», до провайдера не доходит ни одного числа, а дубль оценивается по потолку в пятнадцать секунд, сколько бы ни оказались стоить медиа. Замеры по нашим собственным запускам:
- Клип Avatar на 4,48 секунды и клип на 17,9 секунды обошлись по 31,5 в 720p.
- Двадцатисекундный, в разобранном примере ниже, обошёлся в те же 31,5.
Это переворачивает привычный инстинкт. На посекундной модели вы пишете коротко, чтобы сэкономить; здесь короткий текст впустую тратит секунды, за которые вы уже заплатили. Шесть предложений с двумя отмеченными паузами — это двадцать секунд и один дубль. То же содержание, разбитое на два дубля, — это двойная цена и склейка, которую придётся прятать.
Отсюда правило бюджета: материал с липсинком планируется по сценарию, а не по клипу. Единственный способ сделать дубль короче — написать реплику короче.
Ведущий вход — это часы, поэтому делайте его первым
Длину решает аудио, а значит, аудио должно существовать раньше картинки.
На Avatar это точно, а не приблизительно. WAV-файл на 967 724 байта, 24 кГц, моно — это 20,16 секунды, и клип вернулся длиной 20,16 секунды. Ещё в четырёх дублях каждый клип уложился в 50 миллисекунд от озвучки, которая им управляла, а итоговая звуковая дорожка коррелировала с исходным mp3 на уровне 0,9997 — модель заново выдаёт дорожку, которую вы ей дали, ничего не синтезируя.
Поэтому порядок работы — голос, потом картинка, именно в таком порядке, всегда. Сделаете наоборот — будете подрезать лицо под реплику.
То же правило, со сдвигом на шаг, действует для Animate и Replace, где часами служит исходное видео: его длина, тайминг, камера и частота кадров переходят в результат, и единственный способ изменить что-то из этого — изменить исходник.
Что задаёт картинка, промптом не переспорить
Свойство, которое несёт вход, дальше по цепочке не обсуждается.
Это самый дорогой урок про это семейство, и он проявляется в трёх разных местах.
В выражении лица. На «curious, then a chuckle, then a complicated smile» Avatar возвращает одну сплошную приятную улыбку. Модель управляет ртом по звуковой волне и игнорирует смысл промпта. Когда лицо и есть исполнение, а аудио почти беззвучно, — вот за что OmniHuman 1.5 берёт 200.
В жестах. Рука на исходном кадре — это бит, к которому модель возвращается, а не поза, которую она удерживает. В десятисекундном дубле поднятый указательный палец был поднят на 0,2 с и 1,5 с, исчез к 3 с, вернулся на 7 с и исчез к 9 с. В дублях короче примерно шести секунд руки отыгрывают один раз в начале и уходят из кадра. Так что кадр с жестом даёт вам надёжный начальный бит и ничего, что можно поставить в нужное место, — никогда не пишите план, в котором рука должна быть в кадре в выбранный момент.
В кадрировании. Результат берёт форму от портрета или исходного видео, а не от выбранного вами соотношения сторон. Запрос в 16:9 вернулся в 1280×704, а вертикальный дубль — в 1088×1920: восемь пикселей отступа кодировщика на композиции шириной 1080. Настройка влияет на превью в композере; авторитет — файл. Обрезайте, а не масштабируйте, иначе сдвинется каждая измеренная координата в вашем монтаже.
Стройте из кадров, а не цепочкой
Каждый шаг перерисовывает предыдущий, и дрейф идёт только в одну сторону.
Соблазнительно собрать последовательность, подавая последний кадр каждого клипа в следующий: на стыках не видно склеек, и нужно сделать на одно изображение меньше. Мы собрали так последовательность из четырёх частей и на каждом шаге измеряли отличие области лица от исходного якоря:
29,2 → 35,2 → 36,9 → 41,2.
Ровный рост — именно так выглядит дрейф из поколения в поколение. Если собрать каждую часть из свежего кадра, та же мера даёт 35,6 · 40,2 · 43,6 · 32,7 — без порядка, потому что теперь она отражает позу, а не накопление. Цепочка ещё и замораживает одну позу на весь ролик: героиня ни разу не жестикулирует, не откидывается назад и не делает ничего, кроме как говорит оттуда, где её оставил предыдущий клип.
Стройте цепочку только там, где исполнение действительно продолжается. В той последовательности это заслужил один стык — она всё ещё улыбается экрану, когда начинается следующая реплика, и на ней поднимает глаза. Кадр 0 второго клипа отличался от последнего кадра первого на 3,78/255 — при том что участок голой стены, который никак не мог измениться, давал 3,99. Тот же порядок величины: их разделяет шум перекодирования, и ничего больше.
Во всех остальных случаях свежий кадр — это жёсткая склейка и единственный способ дать плану собственную позу. К тому же дёшево: одно изображение стоит малую долю клипа, который из него вырастает.
У дрейфа есть вторая примета, и её уже можно увидеть. Отличие лица — это число; цвет — это картинка. Средняя насыщенность цвета на фиксированном кропе лица падает в каждом достаточно длинном дубле, а продолжение начинается со значения, на котором закончился предыдущий дубль, — так что падение переносится через стык, а не сбрасывается на нём. Два дубля из одной сессии, оба 9:16, один образ, с разницей в четыре минуты:
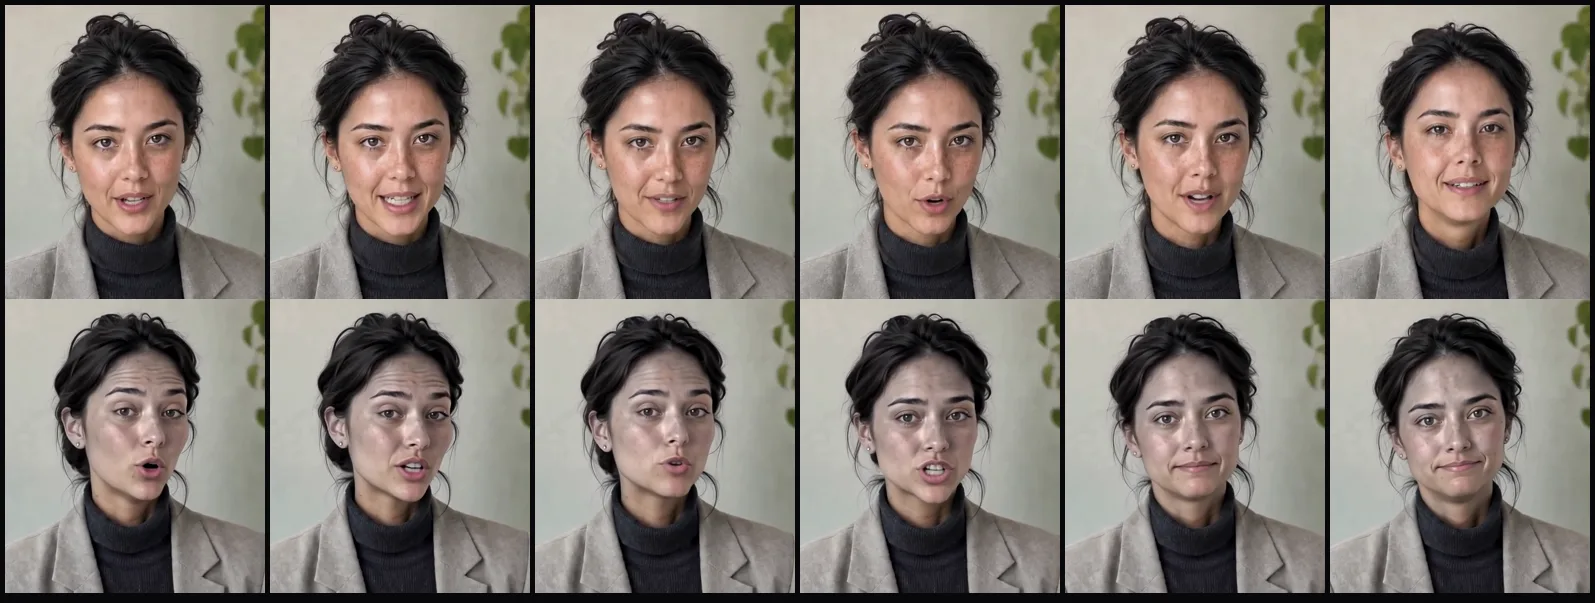
Сверху: дубль, выращенный из собственного кадра, кадры 80–110. Снизу: дубль, который начался с последнего кадра предыдущего клипа, кадры 84–114. Та же одежда, та же стена, тот же свет, разница в четыре минуты.
Верхний дубль теряет 8,6% цвета лица за 4,7 секунды и к концу всё ещё узнаваемо остаётся ею. Нижний дубль — на один шаг дальше. Он начинается на 28% ниже, чем верхний, заканчивается на 44% ниже и теряет 22,6% за свои собственные 4,9 секунды — самое крутое падение из девяти дублей, измеренных нами в тот вечер, и единственный, что закончился ниже 60% от начального значения верхнего дубля. Как выглядит это число — видно на картинке: бледность, восковая кожа без деталей пор, впалые щёки, запавшие глазницы, лицо старше.
Передача буквальная. Кадр 0 неудачного дубля и последний кадр дубля перед ним не похожи — это одна и та же картинка: 36,9 дБ PSNR против 16,7 дБ у не связанной пары из той же сессии.
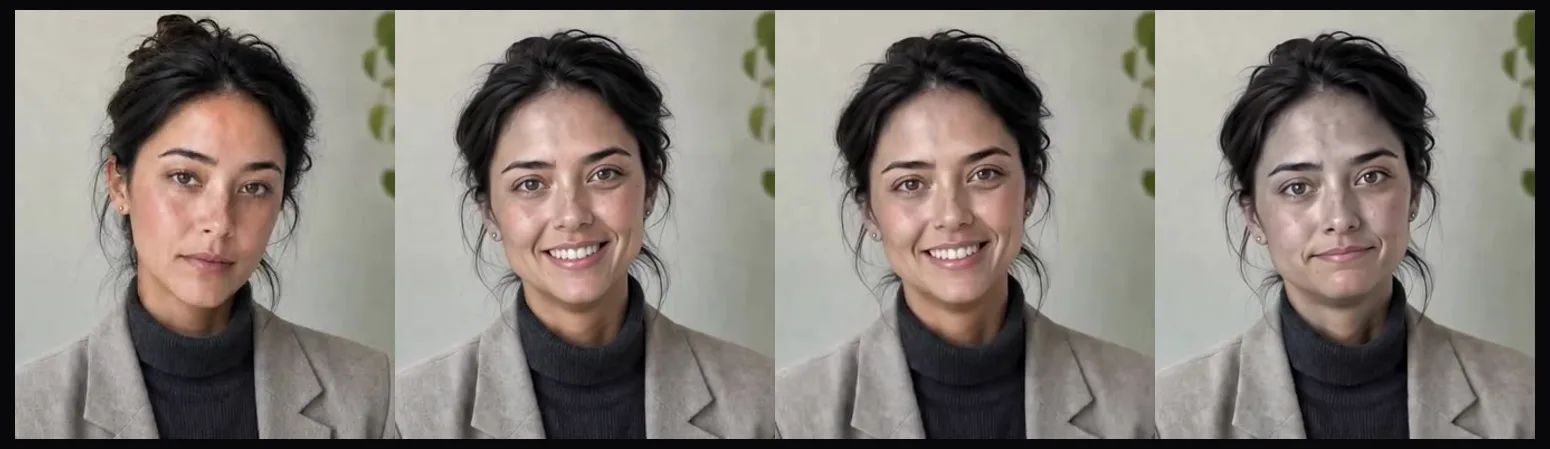
Первый и последний кадр родительского дубля, затем — дочернего. Два средних — одна картинка, переданная дальше. Четвёртый — через 4,9 секунды после неё.
Кадр задаёт бюджет, а дубль его тратит. Дубль первого шага начинается в пределах 4% от цвета кадра, из которого вырос, — во всех четырёх парах, которые нам удалось сопоставить, модель сохраняла то, что ей дали, а потом выцветала. Так что цепочка ломается не в конце. Она ломается на картинке, которую вы ей передаёте, и каждый следующий шаг тратит то, что осталось:
| Дубль | Начинается с | Длина | Начало | Конец |
|---|---|---|---|---|
| 1 | собственного кадра | 3,0 с | 105% | 99% |
| 2 | собственного кадра | 3,0 с | 101% | 103% |
| 3 | собственного кадра | 2,9 с | 95% | 96% |
| 4 | собственного кадра | 5,5 с | 103% | 87% |
| 5 | собственного кадра | 6,7 с | 92% | 75% |
| 6 | собственного кадра | 4,7 с | 100% | 91% |
| 7 | последнего кадра дубля 6 | 10,6 с | 94% | 86% |
| 8 | собственного кадра | 10,6 с | 79% | 71% |
| 9 | последнего кадра дубля 8 | 4,9 с | 72% | 56% |
Девять дублей, одна сессия, один образ, одна комната. Каждая цифра — средняя насыщенность цвета в области лица по первой и последней десятой части дубля относительно начала дубля 6. Бюджет тратят две вещи, и это не одно и то же: длина — три секунды почти ничего не стоят, десять — примерно десятую часть — и шаги. Дубль 7 построен цепочкой и выживает, потому что начался на 94%. Дубль 9 продолжает дубль, который уже начался низко, и приходит туда, откуда не вытащит ни промпт, ни перезапуск.
Поэтому это дёшево отловить. Один проход signalstats из ffmpeg по кропу
лица выдаёт насыщенность по каждому кадру, и два порога отделяют здесь хорошие
дубли от трупа без всяких ухищрений: дубль, который заканчивается более чем
примерно на 15% ниже начала, дрейфует, а дубль, который начинается ниже
исходного кадра, унаследовал уже использованный кадр.
Они оживят сфотографированное лицо
Модели Pruna без возражений принимают фотореалистичный крупный план человека.
Это важно для User-generated content: реклама, снятая так, будто её снял на телефон настоящий покупатель, а не рекламщики.: если вашему ролику нужен правдоподобный человек, говорящий в камеру, по картинке, которая у вас уже есть, это семейство справится. Справится и Veo 3.1 — она сильнее в речи, — но Veo останавливается на восьми секундах и берёт за них 100 на уровне Fast, тогда как двадцать секунд здесь стоят 31,5.
Это не лицензия. Лицо, которое вы не имеете права использовать, остаётся лицом, которое вы не имеете права использовать. Каждый человек в каждом примере на этой странице сгенерирован, и ничего не было сфотографировано.
Тестируйте в 720p, и пусть тестирует цена
1080p стоит вдвое дороже у трёх из четырёх и чуть меньше чем вдвое у Avatar. Больше в дубле ничего не меняется.
Здесь нет репетиционной модели и нет чернового уровня — у провайдера он есть, но каталог намеренно его не подключает, потому что полноценный запуск и так дешевле репетиций большинства моделей. Пять секунд P-Video в 720p стоят 8,5; тот же бриф в 1080p — 17. Понижение уровня меняет резкость и не меняет ничего, чем управляет промпт.
Поэтому рабочий метод такой: запустите в 720p и честно оцените результат. Он отвечает на всё, в чём бриф может ошибиться: такое ли кадрирование, как вы представляли, держится ли движение, принимаются ли входы, выживает ли персонаж. Потом перезапустите те же слова в 1080p для версии, которую оставите.
Одно замечание провайдера работает в обратную сторону: вертикальные ролики, по его словам, лучше держатся в 1080p. Если дубль 9:16 выглядит мягким так, как 720p обычно не объясняет, попробуйте это первым делом.
Четыре модели
Каждая — для своей задачи. Они описаны в том порядке, в котором вы с ними встретитесь: сначала та, которой ничего не нужно, потом три, которым что-то нужно.
P-Video — та, которой ничего не нужно
Для чего она
- Лучше всего для: Кадры, в которых никто не говорит, — пейзаж, руки, улица, деталь. Их вставляют вокруг основных планов, чтобы прикрыть озвучку или дать сцене подышать., крупных планов, анимации продуктов, планов-реакций без реплик и связующей ткани более длинного ролика.
- Чем платите: референсными изображениями. Слота для них нет, так что перенести объект не получится.
- Следите за: соотношением сторон — оно берётся из загруженного кадра, а не из вашей настройки.
Что она принимает
Семь соотношений сторон, от одной до десяти секунд, 720p или 1080p и три необязательных входа, которые меняют то, что делает модель:
Start frame     the clip opens on this exact picture
End frame       the clip arrives at this exact picture
Audio track     the clip is cut to this, and takes its length from it
Прикрепите аудиодорожку — и регулятор длительности исчезнет: решает звук, ровно как у моделей исполнения. Это самый дешёвый путь к музыкальному клипу в каталоге, и аудиовход по такой цене вообще встречается редко.
Звук генерируется по умолчанию и ничего не стоит сверху. В отличие от Veo 3.1, где переключатель звука удваивает ставку, речь и эффекты здесь входят в ту же посекундную цену, пишете вы для них или нет. Провайдер честно признаёт, что звуковые эффекты — слабая половина: для всего, где звук и есть продукт, сделайте дорожку в разделе «Аудио» и передайте её обратно как аудиовход.
Как её писать
Собственная формула провайдера — хорошая отправная форма, и обязательны в ней только первые три части:
[Subject] [Action] [Scene] [Camera] [Lighting] [Style] [Audio]
Две привычки переходят сюда из остальных моделей этой полки и значат больше, чем формула. Называйте то, что видно в кадре, а не операторский термин для этого — описание того, что должно быть на экране, выполняется, а ракурс интерпретируется. И описывайте каждого, кто должен оставаться прежним, один раз, подробно, а потом ссылайтесь на это описание; повторное описание приглашает перерисовку.
Единственное, чего промпт не может, — удержать объект между дублями. Ничто не несёт образ, поэтому если один и тот же человек должен появиться в двух клипах, сначала зафиксируйте его в изображении и передайте это изображение как начальный кадр.
Известные ограничения
README самой модели необычно прямо говорит, где она заканчивается, и наши запуски с ним согласны: никакого экстремального кинематографичного движения камеры, никакого нативного 4K, слабые звуковые эффекты и путаница в том, кто говорит, когда голосов больше двух. Она очень хороша с крупными планами и объектами на переднем плане, но строить вокруг неё историю из нескольких сцен не стоит.
Разобранный пример: Три секунды, в которые ничего не происходит — план-реакция, который не могла снять ни одна другая модель семейства.
P-Video Avatar — портрет и голос
Для чего она
- Лучше всего для: всего, что по сценарию говорится в камеру, — ведущего, объясняющего ролика, UGC-рекламы, локализованной версии уже сделанного материала.
- Чем платите: выбором длины и любым контролем над исполнением сверх того, что уже несут кадр и дорожка.
- Следите за: она управляет ртом по звуковой волне, поэтому беззвучный момент — это не исполнение.
Что она принимает
Два обязательных слота — Изображение аватара и Аудио голоса — и необязательный промпт. Вот и весь рецепт. Голос и тайминг аудио оживляют ваше изображение, а клип длится ровно столько, сколько дорожка, — с точностью до кадра и дальше пятнадцати секунд без доплаты.
Провайдер умеет и сам синтезировать речь — по сценарию и одному из тридцати именованных голосов. Мы намеренно это не подключаем. Раздел «Аудио» уже пишет озвучку на пяти TTS-моделях, так что дубль оттуда и становится голосом аватара, а выбор голоса в продукте один, а не два. Это ещё и делает происхождение понятным: голос существует как отдельная генерация, со своим промптом и своей стоимостью, и сценарий можно переписать и перезаписать, вообще не трогая ведущую.
Как её писать
Это модель, где чем меньше промпта, тем лучше, а часто лучше всего — без него вовсе.
Два обязательных входа уже задают почти всё: кто говорит и что говорит. Промпт — это визуальная режиссура поверх них, а портрет обычно уже решил визуальную режиссуру.
- Используйте чёткий портрет анфас. Сильные ракурсы, перекрытия и низкое разрешение стоят вам узнаваемости.
- Держите аудио чистым. Ясная речь с минимумом фонового шума даёт более точную синхронизацию.
- Закладывайте исполнение в кадр, а не в промпт, — см. правило выше.
Известное ограничение
Она не сыграет прописанную в сценарии смену выражений. Рот следует за звуковой волной, а смысл промпта до лица не доходит. Модель хороша, когда исполнение несёт реплика; когда его несёт лицо, а аудио почти беззвучно, это не та модель.
И ещё одно — из тех, что замечаешь, только присмотревшись: на некоторых сэмплах лицо плывёт, и кадр тут ни при чём. Два клипа из одного прогона вернулись с более узким и жёстким лицом и неровной кожей, хотя все шесть исходных кадров по замерам были идентичны. Перезапуск это исправил. Проверяйте готовые клипы, а не изображения.
Разобранный пример: Ведущая, которой не существует: двадцать секунд, два входа и пустой промпт.
P-Video Animate — исполнение, перенесённое на другого
Для чего она
- Лучше всего для: того, чтобы поместить придуманного вами персонажа в уже имеющееся движение — походку, танец, найденную хореографию, исполнение, которое вы однажды сняли и хотите использовать снова.
- Чем платите: любым контролем, который уже осуществляет исходное видео. Темп, камера, тайминг и звук приходят вместе с ним.
- Следите за: изображение — это образ, а не кадр ноль. Это не начальный кадр, и обращаться с ним как с начальным кадром модель не будет.
Что она принимает
Изображение для анимации плюс Видео ведущего исполнения и необязательный промпт. Объект на вашем изображении повторяет движение исходника, а звук исходника накладывается на результат — всегда. Переключателя нет, поэтому в композере модель значится как требующая звука.
В этом разница между ней и генерацией того же плана из промпта. Перенос движения доказывает, что исполнение можно переложить на кого-то другого; сгенерированная версия доказывает, что модель может придумать походку. Оба утверждения о продукте верны, но только одному нужна отснятая съёмка.
Как её писать
Промпт — это режиссура поверх исполнения. Не само исполнение.
Вот почему бриф для Animate — это четыре предложения, тогда как аналогичный бриф только на промпте занимает четыре абзаца: всё, что иначе пришлось бы ставить промптом, — темп, рука, которая остаётся в кармане, подол пальто, взгляд, приходящий на последних двух шагах, — уже есть в исходнике и не требует записи.
Чего исходник дать не может, так это того, что сохранить при переносе, — для этого и нужен промпт: акценты исполнения и то, что должно остаться неизменным.
- Чёткое, хорошо освещённое движение переносится. Едва заметное или перекрытое — нет, и суетливый исходник с рук — обычная причина неудачного переноса.
- Референс анфас сохраняет образ; сильные ракурсы — нет.
- Кадрируйте исходник так, как хотите видеть результат, потому что результат сохраняет соотношение сторон и частоту кадров исходника.
С чего начать
В каталоге есть опубликованный рецепт на этой модели — Fashion Walk / Outfit Reel: он берёт изображение со стилизованным образом и видео с походкой и даёт вам два слота, уже подписанных. Это самый быстрый способ увидеть форму задачи, прежде чем собирать собственный.
P-Video Replace — тот же план, другой человек
Для чего она
- Лучше всего для: того, чтобы сохранить план и поменять того, кто в нём, — рекламных вариантов для разных рынков, маскота, вставленного в существующую съёмку, одного сильного исполнения, переиспользованного с другими актёрами.
- Чем платите: сценой. Эта модель её не придумывает; она сохраняет ту, что вы дали.
- Следите за: результат хорош ровно настолько, насколько пропорции вашего объекта совпадают с пропорциями оригинала.
Что она принимает
Исходное видео плюс от одного до трёх Образов для замены и
необязательный промпт. Движение, тайминг, камера и сцена остаются в точности
такими, какими были; меняется человек. Частота кадров исходника закреплена на
original, так что ничего не пересэмплируется у вас за спиной.
Это единственная из трёх моделей исполнения, где звук всё ещё на ваш выбор: Animate намертво приваривает дорожку исходника, а здесь переключатель остаётся рабочим.
Как её писать
Три слота для образа вместо одного — вот деталь, которая важна, и на неё стоит потратиться. Три действительно разных вида одного и того же объекта — то, что удерживает замену на плане с движением камеры; три кадра одной и той же позы — это один референс с лишними шагами.
В остальном рекомендации те же, что для Animate, и по тем же причинам: чёткие референсы анфас с минимумом перекрытий и чёткое, хорошо освещённое движение в исходнике. Задача промпта — сказать, как люди с референсов должны вписаться в сцену, и ничего больше.
Как собрать их вместе
Четыре модели ценнее как цепочка, чем как четыре отдельные модели, и цепочка короткая:
an image model      →  a still that settles who and where
P-Video             →  the shots with nobody speaking
P-Video Avatar      →  the shots with a line, one still and one voice take each
P-Video Animate     →  a shot you already have a performance for
P-Video Replace     →  a shot you already have entirely
Вертикальный ролик из двенадцати частей, который мы собрали, устроен почти ровно так: одно якорное изображение держит персонажа, для каждой части — свежий кадр, в котором меняются только направление взгляда и руки, один клип P-Video для беззвучного вступительного бита и по клипу Avatar на каждую часть с речью. Двенадцать частей, из которых семь сняты, обходятся примерно в 700 кредитов с учётом перезапусков, которые нужны первому проходу, — именно это число и стоит называть, потому что расчёт, предполагающий, что всё получится с первого раза, — это не расчёт.
Смотрите расходы в журнале генераций, а не по балансу. На общем аккаунте баланс двигается и из-за чужой работы: из падения на 829 на один фильм пришлось 518, а остальное — кто-то другой, генерировавший в то же время.
Когда что-то ломается
«Кнопка „Сгенерировать“ серая, и я не знаю, чего не хватает»
Пустой обязательный слот. Три из четырёх моделей отказываются запускаться без своих медиа, и композер блокирует запуск, а не гадает.
Решение: посмотрите, что требует модель. Avatar нужны изображение и голосовая дорожка; Animate — изображение и видео; Replace — видео и хотя бы один образ. Если ничего из этого у вас нет, вам нужна P-Video.
«Клип совсем не той длины, что я просил»
Вы её и не просили. У Avatar, Animate и Replace длиной управляете не вы — её задаёт голосовая дорожка или исходное видео.
Решение: измените ведущий вход. Вырежьте предложение из сценария или обрежьте исходное видео. Передача числа ничего не даёт, а число, которое показывает композер, — это потолок в пятнадцать секунд, по которому оценивается дубль.
«Четырёхсекундный клип стоил столько же, сколько двадцатисекундный»
Так работает фиксированная цена, и обычно это хорошая новость.
Решение: исправлять нечего — но перестаньте делить материал на дубли ради краткости. Пишите до потолка: один двадцатисекундный дубль стоит треть цены трёх коротких, и в нём нет швов.
«Лицо изменилось на середине»
Либо ролик собран цепочкой, либо неудачный сэмпл. Бывает и то и другое, и выглядят они похоже.
Решение: если каждый клип выращен из последнего кадра предыдущего, это дрейф из поколения в поколение, и он будет только нарастать — пересоберите каждую часть из собственного кадра. Если части уже собраны из кадров, перезапустите ту, что поплыла, и измеряйте готовые клипы, а не изображения. Быстрее всего читается цвет: часть, которая заканчивается более чем примерно на 15% ниже насыщенности лица, с которой началась, дрейфует, как бы она ни выглядела на первый взгляд, а та, что начинается ниже собственного исходного кадра, получила уже использованный кадр.
«Я попросил жест, а он случился один раз и не вовремя»
Поза исходного кадра — это бит, к которому модель возвращается, а не поза, которую она удерживает.
Решение: считайте жест вступительным битом и не более того. Если рука должна оказаться где-то в выбранную секунду, это задача монтажа, а не промпта.
«Рот двигается, а клип беззвучный — или смеётся ни над чем»
Видимое исполнение поверх дорожки, которая его не несёт, выглядит как дубляж, и наоборот тоже. Это тот самый артефакт, по которому зритель понимает, что лицо сгенерировано.
Решение: согласуйте их. Если бит беззвучный, рот остаётся закрытым — и проверяйте это, а не верьте на слово: замер яркости области рта по всем кадрам решает вопрос так, как просмотр шести кадров не решит, потому что зубы яркие.
«Видео вернулось шириной 1088 пикселей вместо 1080»
Отступ кодировщика. Вертикальный результат регулярно приходит на восемь пикселей шире композиции, под которую делался, а запрос в 16:9 вернулся в 1280×704.
Решение: обрежьте по четыре пикселя с каждой стороны. Не масштабируйте — масштабирование сдвигает каждую измеренную координату в последующем монтаже.
«Я написал нужное выражение лица, а получил другое»
У моделей исполнения промпт не доходит до лица.
Решение: заложите выражение в исходный кадр. Если лицу нужно играть почти в тишине, это работа для модели, которая реагирует на смысл, а не на звуковую волну, и стоит она в несколько раз дороже.
«Перенос размазан или образ поплыл»
Почти всегда дело в исходном видео, а не в модели.
Решение: берите исходник с чётким, хорошо освещённым, однозначным движением и одним объектом в кадре, а также референс анфас. Суетливый клип с рук с перекрытиями — худший случай для этих моделей, и никакой промпт его не спасёт.
Разобранные примеры
Два готовых дубля, к каждому — бриф, по которому он сделан. Оба — это одна генерация, и ни один не склеен из нескольких дублей. Плеер здесь есть только у первого — второй взят из эпизода, который не опубликован, поэтому вместо него приведены замеры, снятые с готового файла.
Для Animate и Replace разобранных примеров пока нет вовсе. Animate мы запускали в продакшене, но и тот дубль не опубликован; придуманный пример стоил бы меньше, чем этот пробел.
Ведущая, которой не существует
P-Video Avatar: один портрет, один голосовой дубль, без промпта.
- Длина
- 20,16 с, один дубль
- Кадр
- 16:9, 720p
- Загружено
- Один портрет, один голосовой дубль
- Стоимость
- 11 + 11 + 3,5 + 31,5
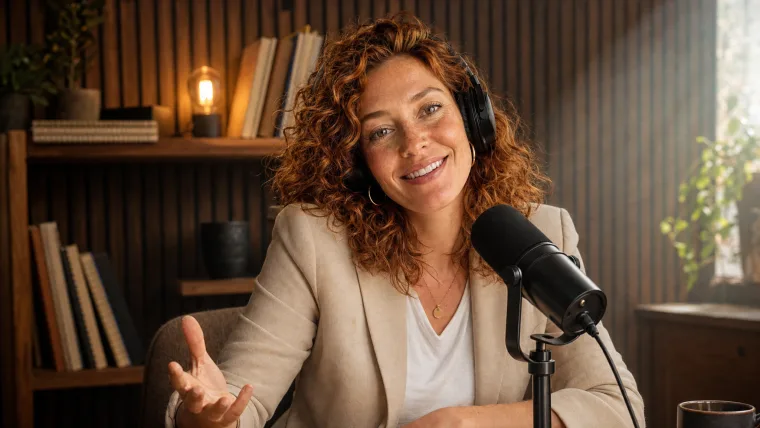
Портрет, сделанный заранее, по изображению образа, сделанному ещё раньше.
Постоянная ведущая читает в камеру двадцать секунд сценария. Ничего не фотографировали и никого не записывали: портрет — сгенерированное изображение, голос — сгенерированный дубль, а клип — это два этих файла, переданные обратно модели.
Промпт пустой. Avatar принимает изображение, аудиодорожку и необязательный
визуальный промпт, и в этом запуске третьего не было вовсе — поле prompt у
генерации содержит пустую строку. Визуальную режиссуру, которую он нёс бы, уже
решил портрет, а исполнением управляет аудио, так что единственный текст,
который человек написал для того, что вы видите, — это текст, который она
произносит.
Клип длится 20,16 секунды, и WAV-файл длится 20,16 секунды. Больше длину ничто не задавало. Шесть предложений с двумя отмеченными паузами — это двадцать секунд, и единственный способ сделать клип короче — написать текст короче.
И стоил он 31,5 — столько же, сколько четырёхсекундный дубль, потому что так оценивает модель исполнения. Два статичных изображения, которые определяют, кто она, обошлись вместе в 22, а это большая часть стоимости клипа: на этой модели дорогая часть — картинки.
Оба брифа целиком
У клипа нет брифа: его промпт — пустая строка. Ниже — голосовой дубль, который им управляет, и стилевой промпт к нему; указания в скобках читаются как ремарки к исполнению и не произносятся.
[warm, conversational, speaking at a natural pace]
I type what I'm picturing, and it comes back real — images, clips, music. [short pause] Want a whole video? The assistant storyboards it, same character in every scene. [short pause] Voiced, scored, done — that's Kuro.
Speak as a warm, reassuring documentary narrator. Unhurried pace, gentle
emphasis, close and friendly.Три секунды, в которые ничего не происходит
P-Video: один начальный кадр, без диалога, без исходной съёмки.
Женщина смотрит что-то на мониторе и молчит. Это вступительный бит более длинного ролика, и именно этот план доказал ценность модели: нет реплики — значит, нет аудио, а значит, у Avatar нет ни длины, ни исполнения, из которых строить, и нет съёмки, которую Animate или Replace могли бы переиграть. P-Video была единственной из четырёх, кто мог его снять.
Он вернулся в 1088×1920, 24 к/с, 97 кадров, 4,042 секунды за 13,5 в 1080p.
Три вещи, которые решает этот дубль, — каждая измерена по готовому файлу, а не на глаз:
Рот не открывается ни разу. В первой попытке она смеялась, а это на фоне
беззвучной дорожки выглядит как дубляж. Яркость области рта по 99-му процентилю
на всех 97 кадрах — зубы яркие, поэтому открытый рот даёт всплеск — даёт
198 199 200 201 202 202 203 230 230 230 229 228 232 на дубле со смехом и
198 200 200 199 198 198 199 201 200 199 199 198 197 на том, что мы оставили.
В первом зубы видны начиная с кадра 56. Второй ни разу не отходит от базовой
линии.
Выражение складывается рано и держится, а не приходит поздней развязкой, и именно поэтому план можно безопасно обрезать с любого конца. Версию со смехом пришлось резать 0,8 → 3,8, чтобы сохранить момент на 2,0 с; у этой беречь нечего, так что работает 0,0 → 3,0, и обрезка идёт с хвоста.
Камера осталась неподвижной, и это проверили, а не предположили. Среднее абсолютное отличие от кадра 0 составляет 1,19–1,43 на голом участке стены и 1,44–1,71 на полке, полной резких краёв, — в обоих случаях это шум кодировщика, и разница между ними около трети уровня серого. Наезд камеры развёл бы эти два ряда на порядок. В декорации не двигалось ничего, кроме неё.
Шаг проверки, который может ошибиться в тревожную сторону, хуже, чем никакого, потому что ему верят. Ранняя проверка сравнила кадр 1152×2048 с кадром 1088×1920 без масштабирования, прошлась по двум разным шагам строк друг против друга и сообщила, что модель перерисовала начальный кадр — на трёх клипах, которые были в порядке. Масштабируйте, прежде чем сравнивать кадры.
Всё это работает в студии.
Любую модель с этой страницы можно выбрать в композере.
Дальше: Готовые рецепты · Что даёт один кредит
Зарегистрироваться